使用 LoRA 进行语义分割
译者:片刻小哥哥
项目地址:https://huggingface.apachecn.org/docs/peft/task_guides/semantic_segmentation_lora
原始地址:https://huggingface.co/docs/peft/task_guides/semantic_segmentation_lora
本指南演示如何使用 LoRA(一种低秩近似技术)来微调 SegFormer 模型变体以进行语义分割。 通过使用🤗 PEFT 的 LoRA,我们可以将 SegFormer 模型中的可训练参数数量减少到原始可训练参数的 14%。
LoRA 通过向模型的特定块(例如注意力)添加低秩“更新矩阵”来实现这种减少 块。微调时,仅训练这些矩阵,而原始模型参数保持不变。 在推理时,更新矩阵与原始模型参数合并以产生最终的分类结果。
有关 LoRA 的更多信息,请参阅 LoRA 原始论文 。
安装依赖项
安装模型训练所需的库:
!pip install transformers accelerate evaluate datasets peft -q
验证以共享您的模型
要在培训结束时与社区分享微调后的模型,请使用您的 🤗 令牌进行身份验证。 您可以从您的 账户设置 。
from huggingface_hub import notebook_login

notebook_login()
加载数据集
为了确保该示例在合理的时间范围内运行,这里我们限制训练的实例数量 的集合 SceneParse150 数据集 至 150。
from datasets import load_dataset

ds = load_dataset("scene\_parse\_150", split="train[:150]")
接下来,将数据集分为训练集和测试集。
ds = ds.train_test_split(test_size=0.1)
train_ds = ds["train"]
test_ds = ds["test"]
准备标签图
创建一个字典,将标签 id 映射到标签类,这在稍后设置模型时会很有用:
标签2id:将数据集的语义类别映射到整数 ids。id2标签:将整数 id 映射回语义类。
import json
from huggingface_hub import cached_download, hf_hub_url

repo_id = "huggingface/label-files"
filename = "ade20k-id2label.json"
id2label = json.load(open(cached_download(hf_hub_url(repo_id, filename, repo_type="dataset")), "r"))
id2label = {int(k): v for k, v in id2label.items()}
label2id = {v: k for k, v in id2label.items()}
num_labels = len(id2label)
准备用于训练和评估的数据集
接下来,加载 SegFormer 图像处理器来准备模型的图像和注释。该数据集使用
零索引作为背景类,因此请确保设置
do_reduce_labels=True
从所有标签中减去 1,因为
背景类不在150个类之中。
from transformers import AutoImageProcessor

checkpoint = "nvidia/mit-b0"
image_processor = AutoImageProcessor.from_pretrained(checkpoint, do_reduce_labels=True)
添加一个函数,将数据增强应用于图像,使模型对于过度拟合具有更强的鲁棒性。这里我们使用 ColorJitter 函数来自 torchvision 随机改变图像的颜色属性。
from torchvision.transforms import ColorJitter

jitter = ColorJitter(brightness=0.25, contrast=0.25, saturation=0.25, hue=0.1)
添加处理灰度图像的函数,并确保每个输入图像具有三个颜色通道,无论
原来是灰度还是RGB。该函数将 RGB 图像按原样转换为数组,对于灰度图像
仅具有一个颜色通道时,该函数使用以下命令将同一通道复制三次
np.tile()
转换前
将图像放入数组中。
import numpy as np


def handle\_grayscale\_image(image):
    np_image = np.array(image)
    if np_image.ndim == 2:
        tiled_image = np.tile(np.expand_dims(np_image, -1), 3)
        return Image.fromarray(tiled_image)
    else:
        return Image.fromarray(np_image)
最后,将所有内容组合到两个函数中,用于转换训练和验证数据。两个函数 类似,只是数据增强仅应用于训练数据。
from PIL import Image


def train\_transforms(example\_batch):
    images = [jitter(handle_grayscale_image(x)) for x in example_batch["image"]]
    labels = [x for x in example_batch["annotation"]]
    输入= image_processor(图像,标签)
    返回输入


def val\_transforms(example\_batch):
    images = [handle_grayscale_image(x) for x in example_batch["image"]]
    labels = [x for x in example_batch["annotation"]]
    inputs = image_processor(images, labels)
    return inputs
要将预处理函数应用于整个数据集,请使用 🤗 数据集
设置变换
功能:
train_ds.set_transform(train_transforms)
test_ds.set_transform(val_transforms)
创建评价函数
在训练期间包含一个指标有助于评估模型的性能。您可以加载评估 方法与 🤗 评估 图书馆。对于此任务,请使用 这 平均交并集 (IoU) 指标(参见 🤗 评估 快速浏览 了解有关如何加载和计算指标的更多信息):
import torch
from torch import nn
import evaluate

metric = evaluate.load("mean\_iou")


def compute\_metrics(eval\_pred):
    with torch.no_grad():
        logits, labels = eval_pred
        logits_tensor = torch.from_numpy(logits)
        logits_tensor = nn.functional.interpolate(
            logits_tensor,
            size=labels.shape[-2:],
            mode="bilinear",
            align_corners=False,
        ).argmax(dim=1)

        pred_labels = logits_tensor.detach().cpu().numpy()
        # currently using \_compute instead of compute
        # see this issue for more info: https://github.com/huggingface/evaluate/pull/328#issuecomment-1286866576
        metrics = metric._compute(
            predictions=pred_labels,
            references=labels,
            num_labels=len(id2label),
            ignore_index=0,
            reduce_labels=image_processor.do_reduce_labels,
        )

        per_category_accuracy = metrics.pop("per\_category\_accuracy").tolist()
        per_category_iou = metrics.pop("per\_category\_iou").tolist()

        metrics.update({f"accuracy\_{id2label[i]}": v for i, v in enumerate(per_category_accuracy)})
        metrics.update({f"iou\_{id2label[i]}": v for i, v in enumerate(per_category_iou)})

        return metrics
加载基础模型
在加载基本模型之前,让我们定义一个辅助函数来检查模型具有的参数总数 其中有多少是可训练的。
def print\_trainable\_parameters(model):
    """
 Prints the number of trainable parameters in the model.
 """
    trainable_params = 0
    all_param = 0
    for _, param in model.named_parameters():
        all_param += param.numel()
        if param.requires_grad:
            trainable_params += param.numel()
    print(
        f"trainable params: {trainable\_params} || all params: {all\_param} || trainable%: {100 \* trainable\_params / all\_param:.2f}"
    )
选择基本模型检查点。对于这个例子,我们使用
SegFormer B0 变体
。
除检查站外,还需通过
标签2id
和
id2标签
字典让
语义分割自动模型
班级知道我们是
对自定义基本模型感兴趣,其中应使用自定义数据集中的类随机初始化解码器头。
from transformers import AutoModelForSemanticSegmentation, TrainingArguments, Trainer

model = AutoModelForSemanticSegmentation.from_pretrained(
    checkpoint, id2label=id2label, label2id=label2id, ignore_mismatched_sizes=True
)
print_trainable_parameters(model)
此时您可以检查
打印可训练参数
辅助函数,所有 100% 参数都在基础中
模型(又名
模型
)是可训练的。
将基础模型包装为 PeftModel 以进行 LoRA 训练
要利用 LoRa 方法,您需要将基本模型包装为
佩夫特模型
。这涉及两个步骤:
- 定义 LoRa 配置
LoraConfig - 包装原稿
模型和get_peft_model()使用上面步骤中定义的配置。
from peft import LoraConfig, get_peft_model

config = LoraConfig(
    r=32,
    lora_alpha=32,
    target_modules=["query", "value"],
    lora_dropout=0.1,
    bias="lora\_only",
    modules_to_save=["decode\_head"],
)
lora_model = get_peft_model(model, config)
print_trainable_parameters(lora_model)
让我们回顾一下
LoraConfig
。为了启用 LoRA 技术,我们必须在其中定义目标模块
LoraConfig
以便
佩夫特模型
可以更新必要的矩阵。具体来说,我们希望瞄准
查询
和
价值
矩阵在
基本模型的注意力块。这些矩阵由它们各自的名称“查询”和“值”来标识。
因此,我们应该在
目标模块
的论证
LoraConfig
。
在我们包装我们的基础模型之后
模型
和
佩夫特模型
连同配置,我们得到
一种新模型,其中仅 LoRA 参数可训练(所谓的“更新矩阵”),而预训练参数
被冷冻保存。这些也包括随机初始化的分类器参数的参数。这不是我们想要的
在我们的自定义数据集上微调基本模型时。为了确保分类器参数也得到训练,我们
指定
要保存的模块
。这也确保了这些模块与 LoRA 可训练参数一起序列化
当使用像这样的实用程序时
save_pretrained()
和
push_to_hub()
。
除了指定
目标模块
之内
LoraConfig
,我们还需要指定
要保存的模块
。什么时候
我们用以下内容包装我们的基本模型
佩夫特模型
并通过配置,我们得到一个新模型,其中只有LoRA参数
是可训练的,而预训练参数和随机初始化的分类器参数保持冻结。
然而,我们确实想训练分类器参数。通过指定
要保存的模块
论证,我们确保
分类器参数也是可训练的,当我们
使用实用函数,例如
save_pretrained()
和
push_to_hub()
。
让我们回顾一下其余的参数:
r:LoRA 更新矩阵使用的维度。阿尔法:比例因子。 *偏见:指定是否偏见应该训练参数。无表示没有一个偏见参数将被训练。
当所有配置完成并且基本模型被包装后,
打印可训练参数
辅助函数让我们探索
可训练参数的数量。因为我们对表演感兴趣
参数高效的微调
,
我们应该期望看到更少数量的可训练参数
劳拉模型
与原来相比
模型
这里确实是这种情况。
您还可以手动验证哪些模块可以在
劳拉模型
。
for name, param in lora_model.named_parameters():
    if param.requires_grad:
        print(name, param.shape)
这证实了只有 LoRA 参数附加到注意力块和
解码头
参数是可训练的。
训练模型
首先定义您的训练超参数
《训练论据》
。但是您可以更改大多数参数的值
你比较喜欢。确保设置
remove_unused_columns=False
,否则图像列将被删除,这里是必需的。
唯一的其他必需参数是
输出目录
它指定保存模型的位置。
在每个纪元结束时,
「教练」
将评估 IoU 指标并保存训练检查点。
请注意,此示例旨在引导您完成使用 PEFT 进行语义分割时的工作流程。我们没有 执行广泛的超参数调整以获得最佳结果。
model_name = checkpoint.split("/")[-1]

training_args = TrainingArguments(
    output_dir=f"{model\_name}-scene-parse-150-lora",
    learning_rate=5e-4,
    num_train_epochs=50,
    per_device_train_batch_size=4,
    per_device_eval_batch_size=2,
    save_total_limit=3,
    evaluation_strategy="epoch",
    save_strategy="epoch",
    logging_steps=5,
    remove_unused_columns=False,
    push_to_hub=True,
    label_names=["labels"],
)
将训练参数传递给
「教练」
以及模型、数据集和
计算指标
功能。
称呼
火车()
微调您的模型。
trainer = Trainer(
    model=lora_model,
    args=training_args,
    train_dataset=train_ds,
    eval_dataset=test_ds,
    compute_metrics=compute_metrics,
)

trainer.train()
保存模型并运行推理
使用
save_pretrained()
的方法
劳拉模型
来保存
仅限 LoRA 参数
本地。
或者,使用
push_to_hub()
方法将这些参数直接上传到 Hugging Face Hub
(如图所示
使用 LoRA 进行图像分类
任务指南)。
model_id = "segformer-scene-parse-150-lora"
lora_model.save_pretrained(model_id)
我们可以看到 LoRA-only 参数只是 大小为 2.2 MB !这极大地提高了使用非常大的模型时的可移植性。
!ls -lh {model_id}
total 2.2M
-rw-r--r-- 1 root root  369 Feb  8 03:09 adapter_config.json
-rw-r--r-- 1 root root 2.2M Feb  8 03:09 adapter_model.bin
现在让我们准备一个
推理模型
并运行推理。
from peft import PeftConfig

config = PeftConfig.from_pretrained(model_id)
model = AutoModelForSemanticSegmentation.from_pretrained(
    checkpoint, id2label=id2label, label2id=label2id, ignore_mismatched_sizes=True
)

inference_model = PeftModel.from_pretrained(model, model_id)
获取图像:
import requests

url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/semantic-seg-image.png"
image = Image.open(requests.get(url, stream=True).raw)
image
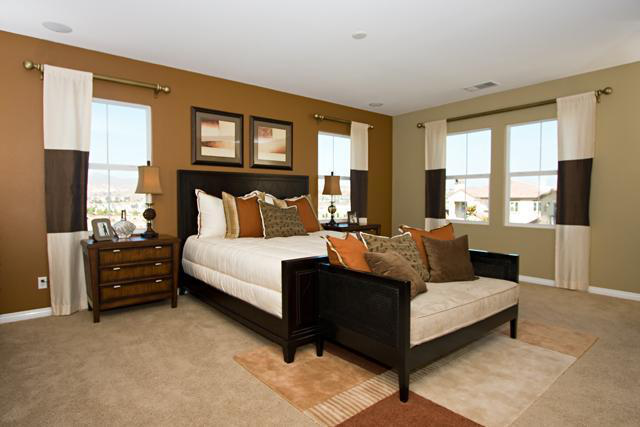
预处理图像以准备推理。
encoding = image_processor(image.convert("RGB"), return_tensors="pt")
使用编码图像运行推理。
with torch.no_grad():
    outputs = inference_model(pixel_values=encoding.pixel_values)
    logits = outputs.logits

upsampled_logits = nn.functional.interpolate(
    logits,
    size=image.size[::-1],
    mode="bilinear",
    align_corners=False,
)

pred_seg = upsampled_logits.argmax(dim=1)[0]
接下来,可视化结果。为此我们需要一个调色板。在这里,我们使用 ade_palette()。由于它是一个长数组,所以 我们未将其包含在本指南中,请从以下位置复制 TensorFlow模型花园存储库 。
import matplotlib.pyplot as plt

color_seg = np.zeros((pred_seg.shape[0], pred_seg.shape[1], 3), dtype=np.uint8)
palette = np.array(ade_palette())

for label, color in enumerate(palette):
    color_seg[pred_seg == label, :] = color
color_seg = color_seg[..., ::-1]  # convert to BGR

img = np.array(image) * 0.5 + color_seg * 0.5  # plot the image with the segmentation map
img = img.astype(np.uint8)

plt.figure(figsize=(15, 10))
plt.imshow(img)
plt.show()
正如您所看到的,结果远非完美,但是,此示例旨在说明以下内容的端到端工作流程: 使用 LoRa 技术微调语义分割模型,并不旨在达到最先进的水平 结果。您在此处看到的结果与在相同设置上执行完全微调时获得的结果相同(相同 模型变体、相同的数据集、相同的训练计划等),但 LoRA 允许用总数的一小部分来实现它们 可在更短的时间内训练参数。
如果您希望使用此示例并改进结果,您可以尝试以下一些操作:
- 增加训练样本数量。
- 尝试更大的 SegFormer 模型变体(探索可用的模型变体 拥抱脸部中心 )。
- 尝试使用不同的参数值
LoraConfig。 - 调整学习率和批量大小。